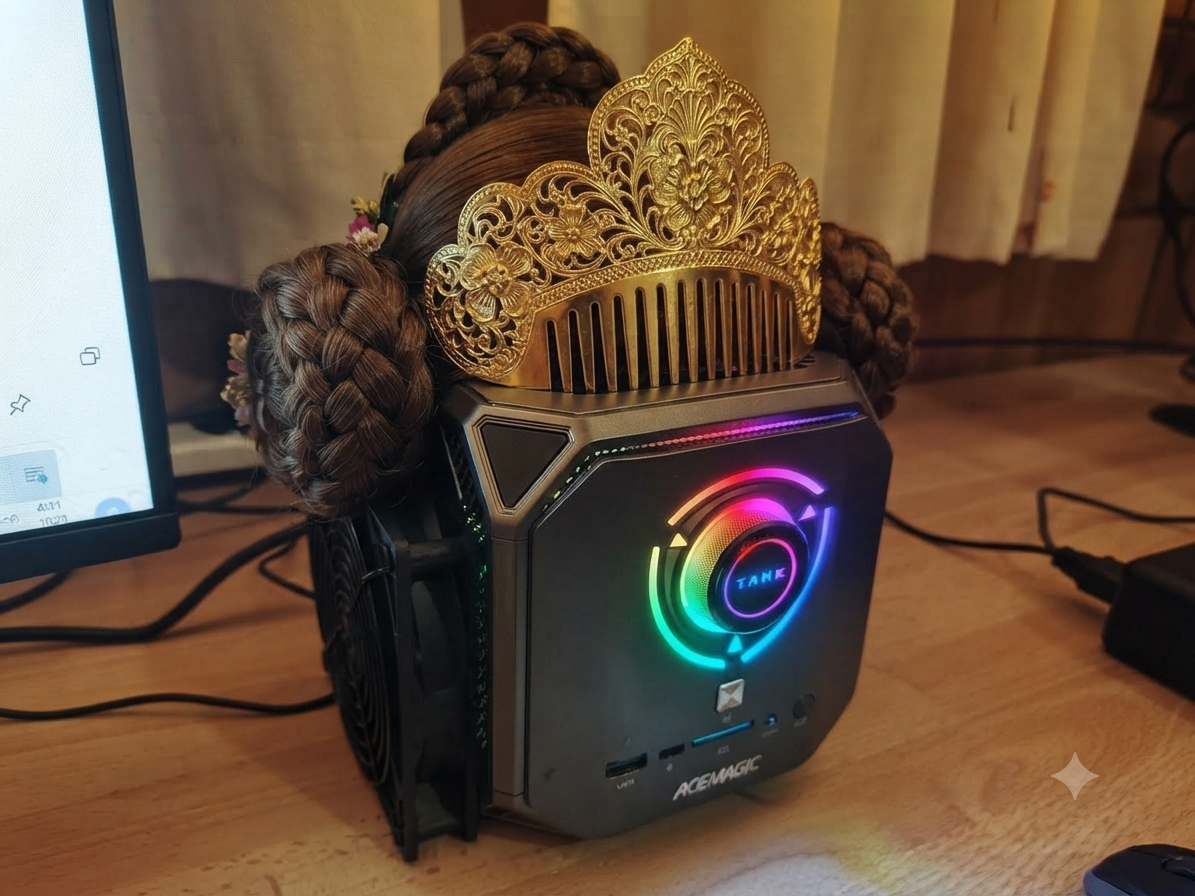
IA Valenciana. Composición creativa de portada aportada por el autor, inspirada en el parecido entre los ventiladores laterales y los moños de una fallera. No representa el montaje físico literal de las pruebas.
01Primero fue la curiosidad
Mi punto de partida era un equipo con 64 GB de RAM DDR5 y dos RTX 5060 Ti de 16 GB. Tenía capacidad de cálculo, pero la memoria de cada gráfica imponía límites: sus 16 GB no se convierten automáticamente en una única bolsa de 32 GB. Repartir un modelo entre ambas requiere soporte del motor y comunicación entre dispositivos.
Entonces me fijé en un Minisforum por su memoria compartida entre CPU y gráfica integrada. Para alojar modelos grandes, esa posibilidad me interesaba incluso más que añadir potencia de cálculo. Lo compré, pero poco después empecé a encontrar alternativas AMD con LPDDR5X y mayor ancho de banda de memoria. Ahí decidí devolverlo y apostar por una plataforma de 128 GB: el ACEMAGIC M1A PRO+.
Lo importante de aquella decisión era la arquitectura: más memoria accesible y una vía distinta para mover los pesos. No sostengo que la gráfica integrada sea más rápida que mis dos RTX en general. Tampoco doy por demostrada una duplicación exacta del ancho de banda respecto al Minisforum, cuyo modelo concreto no queda identificado en esta crónica. La plataforma elegida utiliza LPDDR5X-8000 y un bus de memoria de 256 bits. Especificaciones de AMD.
Mi laboratorio no es un centro de datos ni un servicio de producción. Soy un aficionado con conocimientos técnicos y muchas ganas de experimentar. Me interesan la informática, la inteligencia artificial y, especialmente, saber qué se puede hacer con equipos que uno puede tener en casa, controlar y desmontar.
La pregunta que fue tomando forma era sencilla: ¿dónde está el techo de la IA local? No el modelo más cómodo para conversar, ni el que ofrece la mejor relación entre velocidad y calidad. Quería explorar hasta dónde podía llegar este equipo, aunque la respuesta tardara horas.
Antes de Kimi probamos GLM-5.2, identificado por el motor como un MoE de 744.000 millones de parámetros: ya estábamos por encima de los 700.000 millones. En aquella prueba, el motor llegó a generar aproximadamente dos tokens por segundo. Mi reacción quedó escrita en la conversación del laboratorio: «El resultado es muy bueno y los 2 tokens segundo son suficientes para el tipo de trabajo inicial». Y después vino la pregunta inevitable: «¿Este modelo es nuestro techo máximo? Somos valientes y esto es un laboratorio».
Así llegamos a Kimi K3.
02Un modelo enorme no es una GPU enorme
Kimi K3 es un modelo de mezcla de expertos, o MoE. Su ficha oficial declara 2,8 billones de parámetros totales y 104.000 millones activos. En español, esos 2,8 billones equivalen a 2,8 millones de millones: no son 2.800 millones. La ficha también describe 93 capas y cuantización nativa MXFP4 para pesos, con activaciones MXFP8. Son características del modelo publicado, no resultados de mi laboratorio. Ficha de Moonshot AI.
La palabra «activos» importa mucho. Un MoE no utiliza todos sus expertos en cada paso de generación. Un enrutador selecciona una parte. Los pesos siguen ocupando espacio, pero no todos necesitan participar simultáneamente en cada token.
Ahí está la oportunidad: conservar parte de los pesos en RAM y traer desde los SSD los expertos que hacen falta. Esto no convierte un SSD en memoria RAM ni elimina sus diferencias de latencia. Permite ejecutar una carga que no cabe completa en memoria, a cambio de esperar.
En nuestro caso, la descarga de Kimi ocupaba aproximadamente 1,56 TB, repartidos en 96 archivos de pesos. El ordenador tenía 128 GB de RAM. El modelo no cabía completo, y no voy a presentar el experimento como si lo hiciera.
03La plataforma: memoria, almacenamiento y software
La protagonista es la combinación de memoria, almacenamiento, software y refrigeración. La marca identifica el equipo que utilicé y permite situar el montaje. Esta fue la configuración:
| Componente | Configuración del experimento |
|---|---|
| Ordenador | ACEMAGIC M1A PRO+ |
| Procesador | AMD Ryzen AI Max+ 395 |
| Memoria instalada | 128 GB de memoria unificada |
| Gráfica integrada | Radeon 8060S |
| Almacenamiento de modelos | Tres WD_BLACK SN850X de 1 TB |
| Organización del almacenamiento | RAID 0 por software con mdadm |
| Sistema operativo | Ubuntu 26.04 instalado en un SSD externo conectado por USB |
| Motor de Kimi K3 | Colibri, ejecutables kimi_k3 y kimi_k3-cpu |
| Motor de GLM-5.2 | Colibri, motor C específico identificado como glm_moe_dsa |
| Ejecuciones largas descritas | CPU; no inferencia mediante NPU |
| Refrigeración añadida | Disipadores para SSD y ventiladores laterales |
Colibri fue una pieza fundamental: gestionó la ejecución y la residencia de expertos. GLM y Kimi utilizaron motores específicos distintos dentro del proyecto; el registro de GLM identifica glm_moe_dsa, mientras que las sesiones de Kimi emplearon su ejecutable dedicado. El SSD USB alojaba Ubuntu y dejaba los tres NVMe internos disponibles para el RAID de modelos. No utilizamos una llamada a un servicio remoto para obtener las respuestas. Tampoco debemos atribuir a la GPU las mediciones hechas con el ejecutable CPU. Que el equipo tenga memoria unificada y una gráfica integrada interesante no significa que ambas participaran en esas pruebas. Documentación de Colibri para Kimi K3.
El RAID 0 reparte los datos entre los tres discos. Su atractivo aquí es el rendimiento agregado; su inconveniente es que no tiene redundancia. Si falla una unidad, el volumen completo puede quedar inutilizable. Por eso los resultados y los modelos se respaldaron en almacenamiento externo. El RAID era una herramienta experimental, no una copia de seguridad.
04Diecinueve gigabytes por segundo, con apellidos
Con fio medimos 17,7 GiB/s, equivalentes a unos 19,0 GB/s, durante una prueba de lectura de 60 segundos. Se utilizaron cuatro trabajos, bloques de 1 MiB, profundidad de cola 16 por trabajo y acceso directo. El resumen indicó cero errores y una distribución de lecturas similar entre los tres NVMe.
Es un buen resultado para este montaje. Pero tiene apellidos: lectura secuencial, una carga concreta y un minuto de duración. No significa que cualquier aplicación vaya a leer a 19 GB/s, ni que Kimi mantuviera esa tasa durante toda la inferencia.
Aprendí a mirar con cuidado los contadores. Cuando el motor dice «GB streamed», no debemos convertir automáticamente esa cifra en lecturas físicas de los SSD. Para hacerlo necesitamos contrastarla con los contadores del sistema operativo y de las unidades. Tampoco podemos sumar todos los tiempos internos del motor como si fueran tramos consecutivos: puede haber solapamiento y formas distintas de contabilizar el trabajo.
¿Y si los tres enlaces fueran PCIe 5.0?
PCIe 5.0 duplica la tasa por carril de PCIe 4.0: de 16 a 32 GT/s. Para un enlace x4, el techo tras la codificación, antes de otros gastos del protocolo, pasa aproximadamente de 7,88 a 15,75 GB/s por sentido. Tres enlaces independientes sumarían unos 23,6 frente a 47,3 GB/s teóricos. Referencia de PCI-SIG.
Eso abriría margen para el almacenamiento, pero no permite prometer el doble de tokens por segundo. Harían falta SSD Gen5, enlaces realmente independientes, suficiente capacidad del resto de la plataforma y refrigeración. Estos SN850X seguirían siendo Gen4 aunque se instalaran en ranuras Gen5. Como ejemplo hipotético, si solo la mitad del tiempo total pudiera reducirse a la mitad gracias al disco, la aceleración global sería de 1,33 veces, no de dos. No hemos medido esa fracción en este experimento.
05La parte menos glamurosa: refrigerar los discos
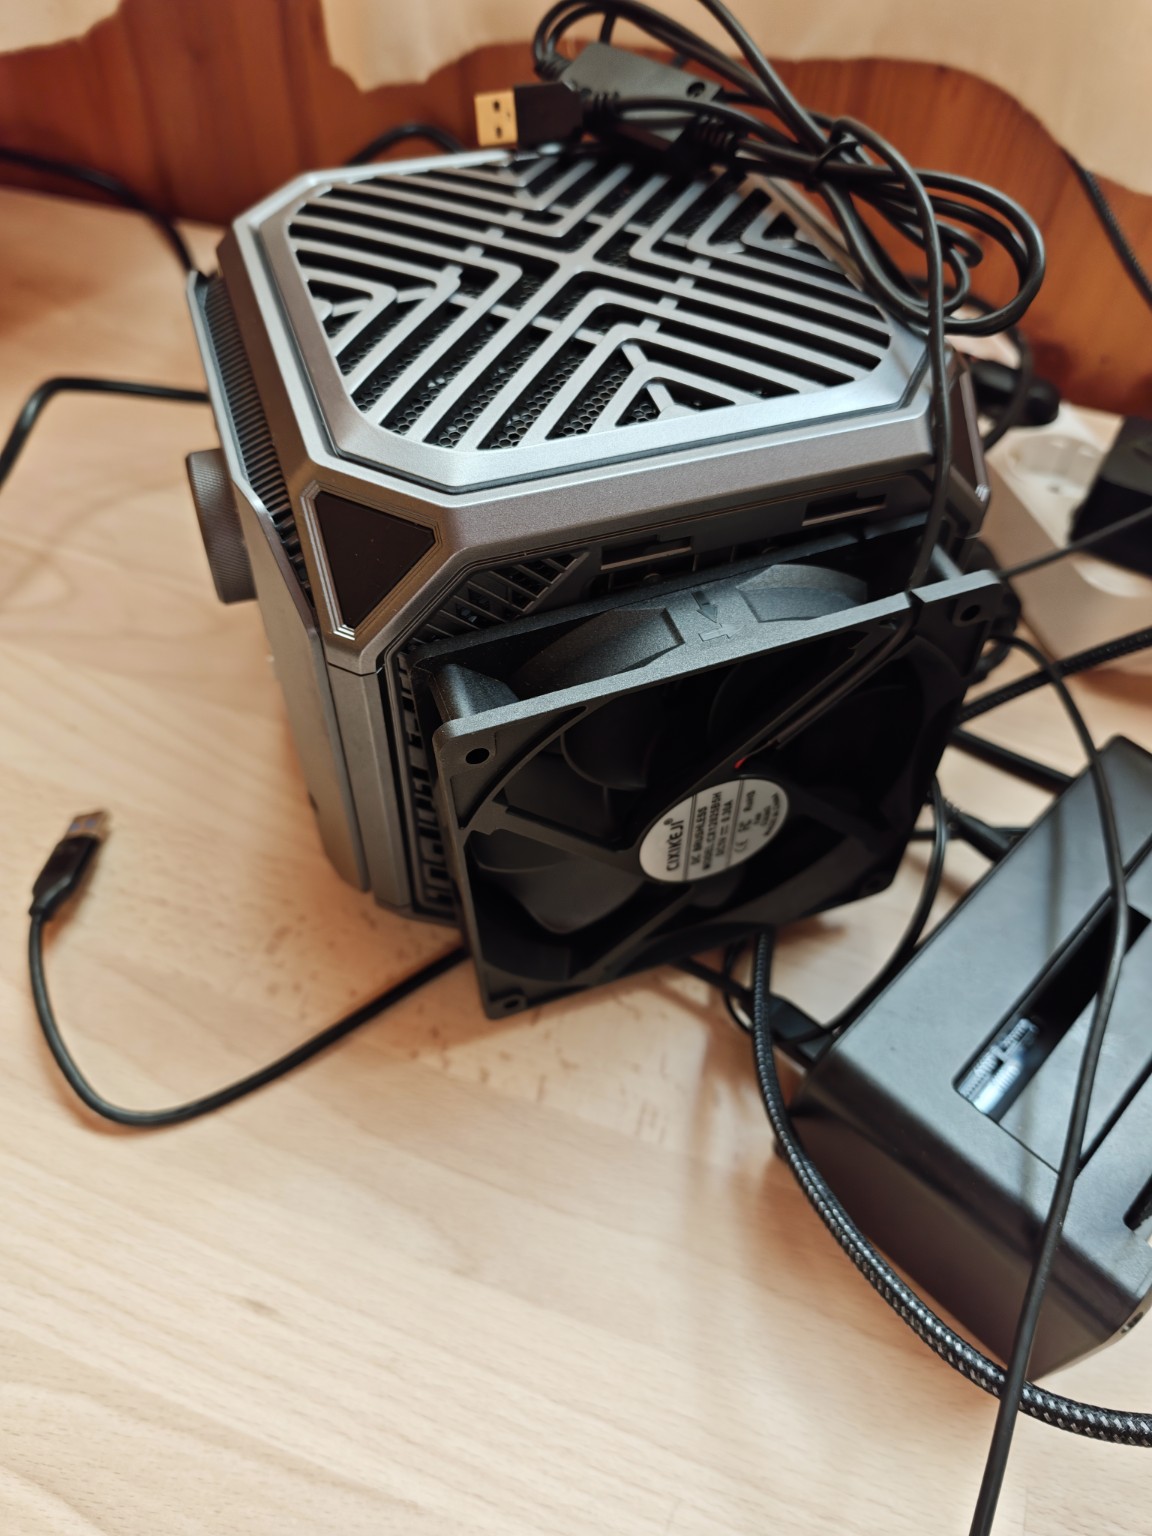
Detalle de la ventilación lateral añadida. Los ventiladores USB de 13 cm forman parte de la solución descrita por el autor; las futuras tapas impresas con soportes integrados todavía están por desarrollar.
Antes de celebrar velocidades, hubo que observar temperaturas. Uno de los SN850X estaba instalado sin disipador y llegó a mostrar alrededor de 78 °C en una prueba anterior. Después monté el disipador que faltaba y reforcé la ventilación lateral.
Mi solución tuvo bastante de «ingeniería española» de andar por casa: ventiladores de 13 cm alimentados por USB, sujetos con abrazaderas. Un montaje sencillo, visible y reversible. Para una siguiente versión quiero imprimir en 3D unas tapas nuevas con rejillas más abiertas y soportes para los ventiladores. Es un proyecto de mejora, todavía no un diseño ensayado.
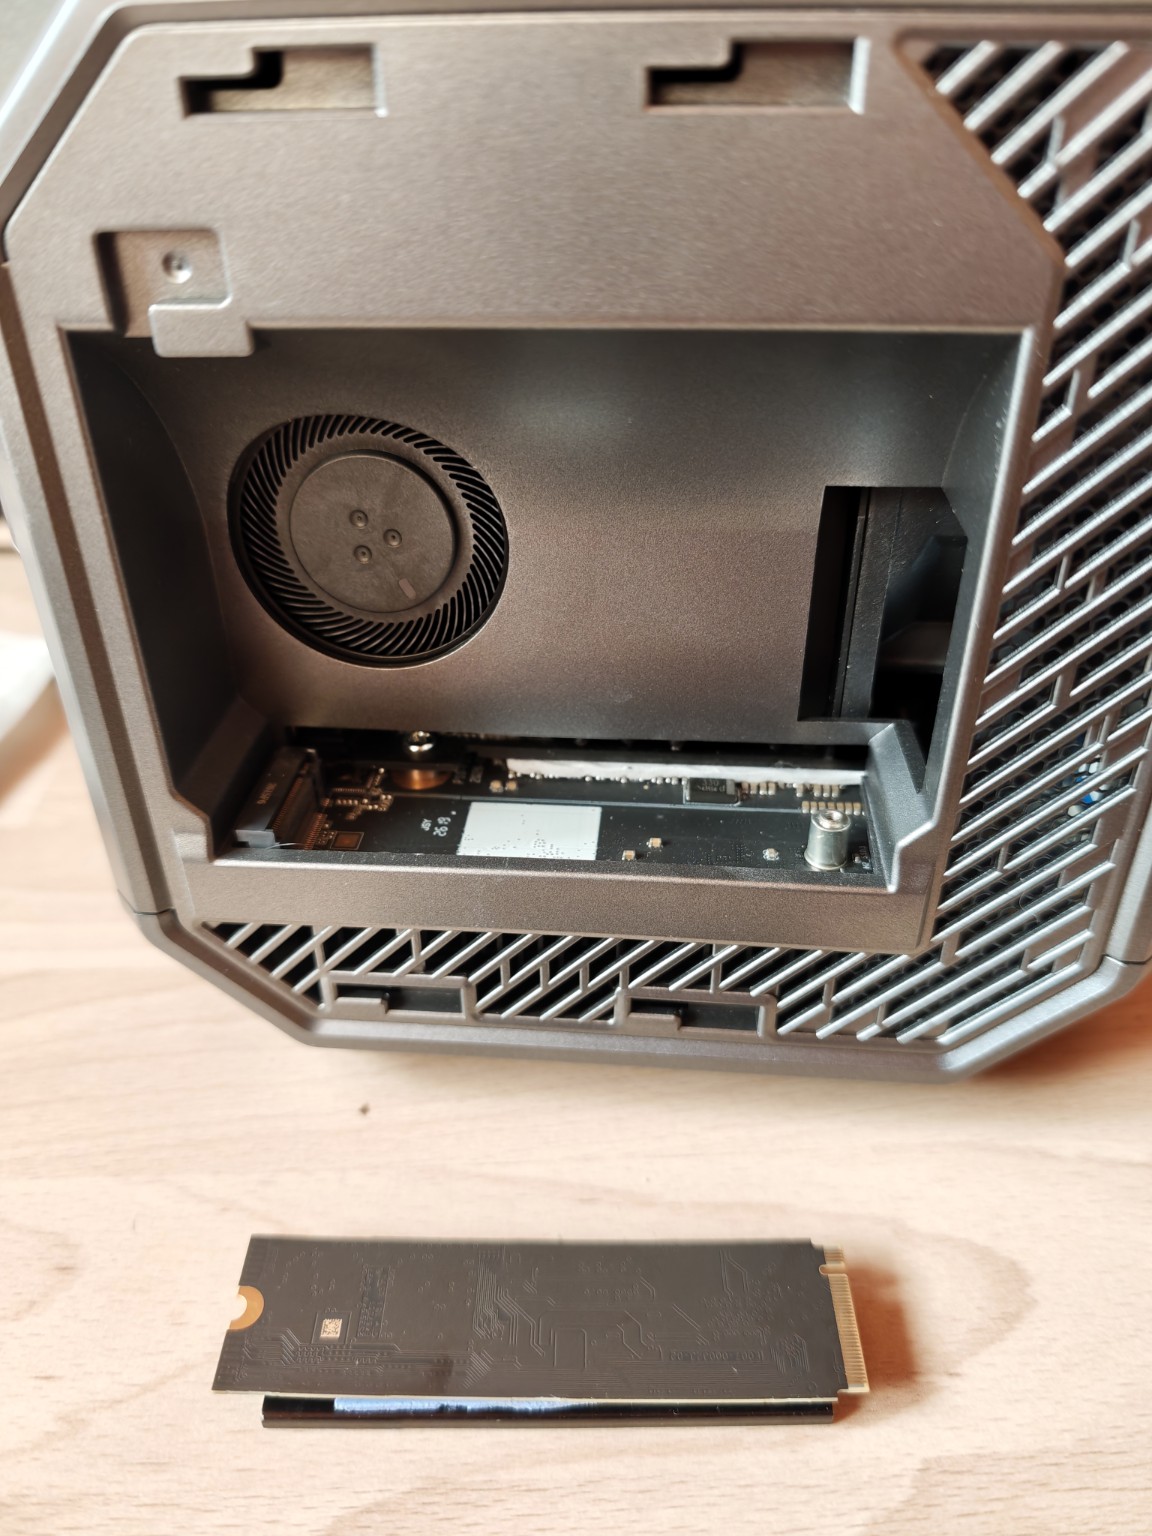
Fotografía del desmontaje posterior: el compartimento de un M.2 ayuda a entender el espacio disponible. No es una fotografía tomada durante la medición térmica.
La temperatura ambiente declarada durante la sesión larga fue de 32 °C, y los ventiladores laterales estaban en modo medio. En los fragmentos registrados bajo carga, la CPU se mantuvo aproximadamente entre 87 y 90 °C; los SSD aparecieron, según el momento y la unidad, entre unos 58 y 71 °C. Son rangos observados en los registros citados, no una certificación de máximos de toda la campaña.
Después de finalizar, las lecturas descendieron: CPU alrededor de 40–46 °C y SSD en torno a 34–36 °C en las muestras mostradas. La RAM utilizada por el sistema también cayó al terminar el proceso.
Esa estabilidad observada es alentadora, pero no demuestra ausencia de limitación térmica. Para afirmarlo harían falta frecuencias, potencia, avisos y rendimiento correlacionados durante la sesión. Tampoco se puede atribuir toda mejora a los ventiladores sin repetir la misma carga en condiciones equivalentes.
Y aquí nació la portada. Al ver los ventiladores laterales pensé que parecían los moños de una fallera. De esa asociación salió la «IA Valenciana»: una forma de ponerle humor y una imagen propia a una aventura de terminales, discos y horas de espera.
06Kimi funcionó. Ahora tocaba esperar
Una cosa es conseguir que un modelo cargue y otra lograr que genere una respuesta larga. Los registros permiten distinguir ambas.
| Prueba | Salida generada | Tiempo de generación | Velocidad del motor | RSS final informado |
|---|---|---|---|---|
| GLM-5.2, referencia inicial | 128 tokens | 63,82 s | 2,01 tokens/s | 103,52 GB |
| Kimi K3, primera sesión larga | 8.192 tokens | 3 h 18 min 58,5 s | 0,69 tokens/s | 95,4 GB |
| Kimi K3, consulta extensa | 16.384 tokens | 8 h 20 min 53 s | 0,55 tokens/s | 96,0 GB |
| Kimi K3, continuación breve | 1.094 tokens | 23 min 46,5 s | 0,77 tokens/s | 95,1 GB |
Los tiempos de la tabla corresponden a generación; no incluyen carga ni procesamiento inicial del texto de entrada. Las pruebas tampoco comparten todas el mismo encargo, longitud o estado de caché. Sirven para describir lo que ocurrió, no para establecer una clasificación universal de modelos.
En la primera sesión larga, el procesamiento de 275 tokens de entrada duró 234,2 segundos. Después llegaron las más de tres horas de generación. En la prueba de 16.384 tokens, la generación por sí sola superó ocho horas.
Un token no equivale a una palabra. Además, parte de esa salida correspondió al texto de razonamiento que emitía el modelo, no al artículo final. Por eso «8K generados» no significa «un artículo de 8.000 palabras» ni siquiera una respuesta completa.
La prueba de 8K terminó con un aviso de contexto lleno y una frase cortada. La de 16K también agotó el presupuesto previsto antes de cerrar completamente la respuesta. Aumentar el límite no garantiza que el modelo termine dentro de él. Finalmente, una continuación más acotada produjo 1.094 tokens y terminó con eos, la señal de final de salida.
¿Merece la pena esperar seis horas por un buen resultado que pueda procesarse de forma privada? Para mí, puede merecerla: un trabajo que dejo por la noche no tiene las mismas exigencias que una conversación interactiva. Pero seis horas es aquí un ejemplo de tolerancia a la espera, no la duración medida de nuestra consulta extensa, que superó ocho horas de generación.
La condición es que el resultado sea útil y verificable. Revisamos el artículo de 8K, la respuesta extensa de 16K y su continuación: hay aportaciones aprovechables y errores importantes. Más abajo explico esa valoración. La prueba demuestra que podemos generar textos extensos localmente; todavía no demuestra que esperar más produzca mejores respuestas que un modelo pequeño. La privacidad depende también del aislamiento y de cómo guardemos esos textos.
07También probamos Vulkan: la GPU no ganó esta vez
No nos quedamos en CPU. Compilamos el backend Vulkan y el registro identificó la Radeon 8060S con el controlador RADV. Hicimos una comparación corta con el mismo arranque de relato y 128 tokens de salida.
| Configuración | Tiempo de generación | Velocidad |
|---|---|---|
| CPU | 169,927 s | 0,75 tokens/s |
| Vulkan, presupuesto de 8 GB | 186,083 s | 0,69 tokens/s |
| Vulkan, presupuesto de 16 GB | 187,950 s | 0,68 tokens/s |
En esas ejecuciones, Vulkan tardó aproximadamente un 9,5 % y un 10,6 % más que CPU. Aumentar el presupuesto del nivel de expertos en GPU tampoco mejoró el resultado.
Es una observación concreta, no una sentencia contra la 8060S ni contra Vulkan. Cambian el backend, sus transferencias, la caché y la carga. Con 16 GB modificamos además la velocidad de incorporación de expertos; no fue una prueba aislada de una sola variable. Y no hubo suficientes repeticiones para calcular dispersión estadística.
Incluso con temperatura de muestreo cero apareció una variación en el relato entre CPU y Vulkan. Eso nos recuerda que seleccionar el token más probable no exige que distintos caminos numéricos produzcan siempre una secuencia idéntica.
08¿Se estaba conectando a Internet?
Mientras generaba, Kimi utilizó la expresión «public knowledge». Mi reacción fue comprobar si estaba consultando algo fuera del equipo.
Las comprobaciones mostraron Wi-Fi desconectado y bloqueado por software. Bluetooth seguía activo para el ratón. lsof y ss no mostraron conexiones TCP/UDP del proceso inspeccionado. Esa expresión no era una prueba de navegación: un modelo puede referirse a información aprendida sin consultar una web.
Conviene no exagerar tampoco esta comprobación. Una inspección puntual de sockets no es una auditoría de red continua, y desactivar Wi-Fi no excluye por sí solo otras interfaces. Lo que documentamos es la ausencia de conexiones del proceso en esos instantes y el estado de la radio. La privacidad local se construye con configuración y controles, no con un eslogan.
09El consumo: el enchufe medía más que el ordenador
El medidor mostró unos 34 W en reposo para el conjunto y un pico observado de 199,6 W bajo carga. En esa medición estaban incluidos el ACEMAGIC, los ventiladores laterales y un monitor Xiaomi de 27 pulgadas.
Además, durante la sesión larga leí aproximadamente 1,5 kWh de energía acumulada en el medidor de enchufe. Era un medidor doméstico, no un instrumento de precisión: la cifra sirve para hacerse una idea del orden de magnitud. Es una lectura comunicada por mí, no una integración calculada a partir de los logs ni una medida con incertidumbre calibrada.
Ese consumo corresponde al conjunto conectado al medidor, no exclusivamente al procesador ni al mini-PC. Sin un registro sincronizado de inicio y fin no lo convierto en un consumo exacto por token. A un precio ilustrativo de 0,25 €/kWh, 1,5 kWh serían unos 0,38 euros de energía: no es un coste total del servicio, porque no incluye equipo, almacenamiento ni mi tiempo de revisión.
Potencia y energía cuentan cosas distintas. Los 199,6 W son un pico observado; los 1,5 kWh son la lectura acumulada aproximada de la sesión. Una cifra no se obtiene multiplicando arbitrariamente la otra por horas.
10Le pedí a Kimi que escribiera sobre sí mismo
La parte más curiosa fue pedir al propio Kimi que ayudara a redactar un artículo sobre el experimento. Dejamos de probar frases mínimas y pasamos a un encargo de análisis, arquitectura y propuesta para el laboratorio.
El borrador ofreció estructura, explicaciones y una lista de limitaciones. Pero también dejó claro por qué hay que revisar una respuesta aunque venga de un modelo enorme.
Por ejemplo, trató las temperaturas y el consumo como pendientes porque esos datos no estaban en su encargo, aunque nosotros los estábamos registrando por separado. En otros pasajes atribuyó trabajo a CPU y GPU conjuntamente, cuando las ejecuciones largas descritas fueron CPU. También presentó conclusiones demasiado rotundas sobre privacidad y sobre el almacenamiento como único límite.
En una continuación propuso estimar desgaste mediante TBW a partir de las lecturas. No debemos confundir terabytes leídos con terabytes escritos: los contadores de lectura no permiten calcular directamente el presupuesto de escritura consumido. Del mismo modo, haber registrado millones de selecciones o muchos expertos visitados no demuestra por sí solo una mayor calidad intelectual.
Qué calidad encontramos al leer la respuesta extensa
La revisión es cualitativa y sobre estas salidas concretas; no es un benchmark ciego ni una nota general de inteligencia. El texto de 16K tiene fortalezas: organiza un problema complejo, separa hechos e hipótesis, reconoce que faltan datos y propone caracterizar los equipos antes de comprar más hardware. Pero su buena estructura puede hacer que errores técnicos pasen desapercibidos.
| Aspecto revisado | Resultado y límite |
|---|---|
| Organización | Construye una arquitectura por capas, un plan de pruebas y una propuesta ejecutiva aprovechables como borrador. |
| Cálculos de duración | La relación tiempo = tokens / velocidad y los cálculos principales son útiles; hay que distinguir estimaciones redondeadas de tiempos medidos. |
| Diagnóstico del cuello de botella | Divide lecturas por tokens y por tiempo, y vuelve a combinar ambas tasas para «demostrar» que el disco explica todo. Es una identidad aritmética, no una prueba causal del límite de E/S. |
| Rigor técnico | La fórmula que compara directamente ancho de banda y tokens/s mezcla unidades. La continuación confunde lecturas con desgaste medido en TBW. |
| Calidad frente a otros modelos | Sugiere preferir Kimi por capacidades que no hemos comparado aquí. El tamaño y el número de expertos no bastan para justificarlo. |
| Finalización | La respuesta de 16K quedó truncada; la continuación acotada terminó. El presupuesto de tokens condicionó la entrega. |
Mi balance: un borrador útil para ordenar ideas y encontrar preguntas, pero no un informe listo para publicar sin revisión. Para un encargo privado cuyo valor lo justifique, aceptaría una espera larga; lo que no puedo afirmar todavía es que Kimi ofrezca mejor calidad que alternativas más rápidas en ese mismo encargo.
Kimi fue un colaborador de redacción, no un instrumento de medida. Sus explicaciones se pueden contrastar; sus afirmaciones no sustituyen los registros. Este artículo une mi experiencia, las mediciones y una revisión de aquel texto, en lugar de publicarlo sin comprobar.
11Lo que hemos demostrado y lo que queda abierto
Hemos documentado ejecución local de Kimi K3 mediante Colibri en un equipo de 128 GB, con pesos que exceden ampliamente esa memoria. Hemos obtenido salidas largas, medido sus tiempos y comparado unas configuraciones CPU y Vulkan. También hemos observado el comportamiento térmico y conservado resultados fuera del RAID.
Prácticamente todos los expertos, a lo largo del historial
Al terminar la prueba de 16K, el registro acumulado mostraba 82.226 expertos distintos y 46.270.848 selecciones. La configuración publicada declara una primera capa densa y 92 capas MoE con 896 expertos enrutados cada una: 82.432 posiciones de expertos. Esa cobertura acumulada equivale aproximadamente al 99,75 %. Configuración de Kimi K3.
Es un dato destacable: el historial recorrió prácticamente todo ese conjunto, no un pequeño grupo fijo. Pero el proceso había cargado 17.880.384 selecciones anteriores al empezar; por eso no atribuyo la cobertura completa a una sola consulta, ni digo que todos los expertos se activaran a la vez.
En la sesión de 16K hubo un 42 % de aciertos de caché de expertos y el motor contabilizó 261.293,7 GB de tráfico lógico. Esto documenta una carga prolongada de gestión y lectura de pesos. No demuestra por sí solo que el RAID permaneciera al 100 % de su capacidad física: para decir «a tope» en sentido cuantitativo necesitamos las lecturas físicas y sus tiempos correlacionados.
No hemos demostrado que sea el mayor modelo ejecutado jamás en un mini-PC. No hemos medido equivalencia con el servicio del fabricante ni superioridad frente a modelos pequeños. Tampoco hemos evaluado sistemáticamente precisión, programación, traducción o calidad con una batería independiente.
El contexto admite otra cautela: las capacidades anunciadas por el fabricante no son automáticamente las capacidades probadas por este motor, con esta cuantización y esta memoria. En esta entrega hablamos de generación textual y de los límites concretos ensayados.
Para seguir avanzando, priorizaría pruebas acotadas y repetibles, registros físicos de entrada/salida, energía medida con mayor precisión y tareas cuya respuesta podamos evaluar. Ejecutar más tokens solo porque caben en un parámetro no equivale a aprender más del experimento.
12Mi conclusión: no es mi asistente más rápido, pero sí una buena pregunta hecha máquina
Cambiar aquel Minisforum por el ACEMAGIC terminó convirtiéndose en algo más que una compra de hardware. Fue el comienzo de una exploración: qué pasa cuando mucha RAM, tres SSD rápidos y un motor especializado se ponen al servicio de una pregunta aparentemente desproporcionada.
Mi valoración sigue siendo la que dejé escrita durante las pruebas: «Para mí ha sido ya todo un éxito que funcione».
Eso no convierte al equipo en un centro de datos, ni hace de Kimi la elección sensata para cualquier tarea. Para trabajo diario puede convenir mucho más un modelo pequeño, rápido y bien elegido. Pero como aficionado, encuentro valor en entender por qué algo funciona, cuánto tarda y qué peaje exige.
La IA Valenciana tiene moños en la portada, ventiladores de verdad en los laterales y una lección bastante seria detrás: el tamaño del modelo no lo explica todo. Importan el software, la memoria, el almacenamiento, la refrigeración y, sobre todo, saber distinguir lo que hemos medido de lo que nos gustaría haber demostrado.
Fuentes y notas de reproducibilidad
Pruebas realizadas en septiembre de 2026. Resultados propios extraídos de los registros aportados por el autor: baseline-linux-raid3-disipador-wifi7-cold-128.txt, kimi-k3-cpu-8k-articulo-20260908.txt, kimi-k3-cpu-inteligencia-16k.txt, kimi-k3-cpu-inteligencia-continuacion-2k.txt, kimi-k3-comparacion-cpu-vulkan.txt, registros térmicos y comprobaciones de conectividad. El archivo de preservación es resultados-articulo-ACEU26-20260909.tar.gz.
La ficha de Moonshot AI se utiliza para características del modelo; los registros locales, para resultados del experimento. La documentación actual de Colibri explica el proyecto, pero no sustituye la identificación del código empleado en cada prueba. Se ha preparado un paquete documental para GitHub y GitLab con extractos técnicos seleccionados, métricas, una revisión de calidad y hashes de los archivos distribuidos. Omite conversaciones completas, topología privada, números de serie y datos de acceso. Los extractos conservan los valores numéricos; no se presentan como logs originales íntegros. No incluye los pesos ni los binarios del modelo. Las revisiones y comandos que no se puedan vincular inequívocamente a cada prueba quedan señalados como pendientes, sin inventarlos. Los repositorios públicos y sus enlaces se incorporarán cuando se publiquen.
Transparencia editorial: relato en primera persona redactado a partir de la experiencia y conversaciones del autor, con asistencia de IA. El borrador generado por Kimi fue revisado y no se considera una fuente independiente. Las fotografías del montaje son aportaciones del autor; la portada es una composición creativa. Este texto describe un laboratorio aficionado, no una guía de instalación ni una garantía de rendimiento o seguridad.
Sobre el autor
Koldo Menoyo cuenta con más de treinta años de experiencia en telecomunicaciones en Telefónica. Su formación incluye másteres en Ciberseguridad por la Universidad Nebrija, Inteligencia de Negocio y Big Data por la Universitat Oberta de Catalunya, Business Intelligence sobre tecnologías Microsoft en SolidQ University y el máster en Inteligencia Artificial con Big School. Se define como un aficionado a la tecnología: en su laboratorio doméstico explora los límites de los modelos locales, la memoria y el almacenamiento. En Iapedia comparte resultados, aprendizajes y errores, con especial interés por la privacidad y la experimentación verificable. Perfil profesional en LinkedIn.